데이터 정제가 빠지면,
AI 성과도 빠집니다.
모든 AI 파이프라인에는 데이터를 분류하고 정리하는 단계가 있습니다. 인력을 늘리고, 패턴 기반 도구와 정책을 도입해도 데이터 증가 속도를 따라가지 못합니다.
기업 데이터가 대규모 AI 활용에 완전히 준비되었다고 답한 조직은 6%에 불과합니다.DUN & BRADSTREET · 32개국 10,000개 기업 조사 · 2026년 3분기
대규모 AI에 기업 데이터가 완전히 준비되었다고 답한 조직
Dun & Bradstreet, 2026 Q3
데이터 정제가 부족하면 조직 전반에 이런 증상이 나타납니다.
파악되지 않은 데이터 노출
개인정보·기밀이 어디에 있는지 모른 채 AI에 유입
핵심 IP 유출
설계도·소스코드가 사내 LLM, Copilot을 통해 노출
일정 지연
보안·법무 검토에 막혀 PoC가 본사업으로 넘어가지 못함
GPU 자원 낭비
불필요한 데이터까지 학습해 연산·스토리지 비용 증가
낮은 결과 품질
정제되지 않은 데이터로 부정확한 답변과 환각 발생
다른 방법이 있습니다.
Know. Protect. Unleash.
알고, 보호하고, 활용하십시오. 파일을 처음 발견한 순간부터 그 파일을 사용하는 AI 파이프라인까지, 올바른 데이터가 모든 단계를 따라갑니다.
KNOWIP까지 자동으로 분류해
우리 데이터를 정확히 파악합니다
모든 파일을 원래 위치에서 맥락까지 확인해 분류합니다. Secuvy가 분류하면 담당자가 확인하고, 그 결과로 다시 학습하는 순환이 계속됩니다. 사람의 일은 예외 항목 검토로 줄어듭니다.
탐색 및 분류 기능 보기 →PROTECT무엇을 빼야 하는지 알면
데이터를 지킬 수 있습니다
AI 개발자는 용도별로 묶인 데이터를 받아 바로 복제하고, 정제하고, 마스킹할 수 있습니다. 페타바이트 규모의 데이터를 원래 위치에서 분류하고, 새로 생기는 파일도 즉시 처리합니다.
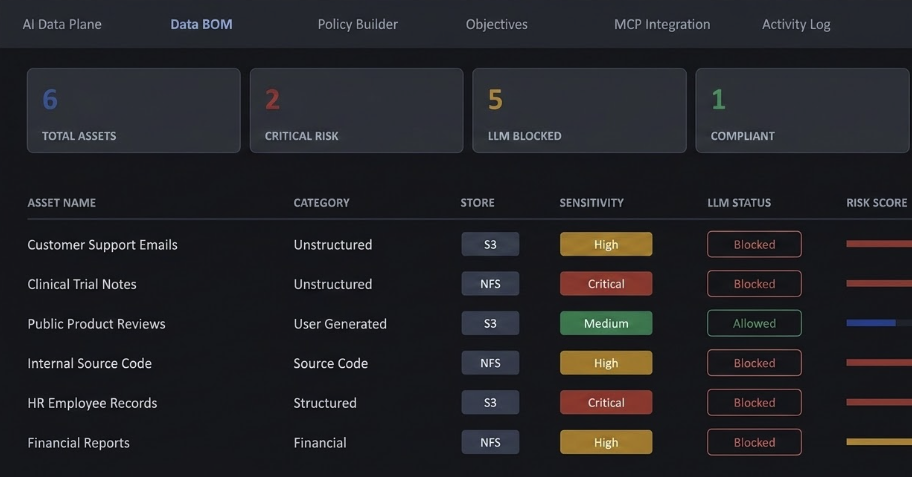
모든 파이프라인에는 데이터 명세서(DBOM, Data Bill of Materials)가 생성되어 무엇이 학습에 쓰였고, 무엇이 제외되었는지 감사 근거로 남습니다.
거버넌스·리스크·컴플라이언스 보기 →| 데이터셋 | 유형 | 소스 | 판정 |
|---|---|---|---|
| 고객센터 상담 이메일 | 비정형 | S3 | 마스킹 후 사용 |
| 임상시험 기록 | 비정형 | NFS | 학습 제외 |
| 제품 공개 리뷰 | 사용자 생성 | S3 | 사용 가능 |
| 설계 도면(AutoCAD) | 비정형 | SMB | IP · 제외 |
| 제품 데이터시트 | 문서 | O365 | 사용 가능 |
UNLEASH신뢰할 수 있는 데이터를
AI에 바로 투입합니다
활용 목적에 맞는 데이터를 고르면 연결 → 인라인 분류 → 재배치 → 임베딩까지 하나의 흐름으로 진행됩니다. Hammerspace AI 데이터 플랫폼(AIDP)과 연동해 승인된 데이터만 GPU로 전달합니다.
정확도는 스스로 높아지고,
수작업은 0에 가까워집니다.
다른 제품에서는 찾을 수 없는 세 가지입니다.
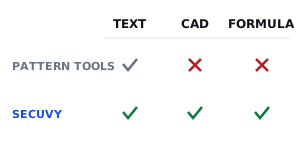
패턴 없는 분류Non-Pattern Classification
정규식이나 사전 정의 패턴 없이 IP와 민감 데이터를 찾아냅니다. 미처 생각하지 못한 신호까지 드러내고, 담당자의 확인을 학습해 더 정확해집니다.
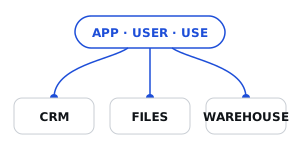
전체 맥락 연결Full Contextual Linkage
CRM·ERP·설계·계약·재무 등 여러 시스템에 흩어진 관련 데이터를 연결해, 해당 애플리케이션·사용자·용도와 함께 지식 그래프로 매핑합니다.
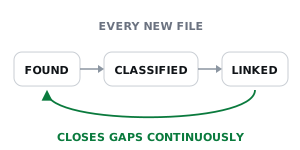
항상 최신인 파이프라인Always-Current Pipelines
탐색과 분류가 멈추지 않고, 결과가 해당 데이터를 쓰는 파이프라인에 바로 연결됩니다. 새로 생긴 파일도 놓치지 않습니다.
Secuvy가 분류하고, 담당자가 확인하면, 시스템이 학습합니다.
예시: 같은 단어, 다른 의미 — 맥락으로 판단합니다
AI 도입 단계별 활용 사례
학습 데이터 준비부터 사내 RAG, 생성형 AI 사용, 데이터 국외 반출 통제까지. 한 번 분류한 결과를 모든 단계가 함께 씁니다.
AI 학습 데이터 준비 자동화
GPU와 파이프라인은 준비됐는데, 파일마다 무엇인지 사람이 태깅하느라 데이터가 준비되지 않습니다.
- 규칙 작성 없이 데이터 소스에 연결해 모든 파일을 자동 분류·태깅
- 담당자는 일일이 태깅하는 대신 결과만 확인
- 데이터 이동 없이 원위치에서 처리, 24시간 안에 첫 결과
생성형 AI 사용 시 프롬프트 사전 점검
직원들이 ChatGPT, Copilot, Claude, Gemini에 사내 문서를 그대로 붙여 넣고 있습니다.
- Secuvy가 MCP 서버로 사용자와 AI 모델 사이에서 동작
- 모든 프롬프트와 첨부 파일을 맥락으로 읽고, 정책 위반 내용을 외부 전송 전에 표시
- 사내 RAG 앱과 LLM API 호출에도 같은 기준 적용
사내 RAG · 지식검색 구축
RAG는 원본 파일을 벡터 DB로 복사하는데, 원본의 접근 권한은 복사본에 따라가지 않습니다.
- 임베딩 전에 모든 소스를 분류하고 색인 허용 여부를 태깅
- 허용된 데이터만 검색 결과에 나오도록 처음부터 깨끗한 코퍼스 유지
- 새 문서가 추가되어도 자동으로 분류해 상태 유지
데이터 주권 · 국외 반출 통제
프롬프트 하나로 데이터가 국경을 넘거나, 회사의 핵심 지식이 외부 모델로 나갈 수 있습니다.
- 민감도, 관할 지역, 모델 학습 가능 여부로 파일을 분류
- 공개 데이터는 외부 모델로, IP는 사내·국내 모델로 구분
- 온프레미스, 클라우드, 폐쇄망(에어갭) 구성 모두 지원
- 통제 데이터가 관할 지역 안에 머물렀다는 증빙을 DBOM으로 제공
산업별 활용 사례
산업마다 민감한 데이터는 모양이 다릅니다. 패턴 규칙으로는 잡히지 않는 데이터를 Secuvy는 내용과 맥락으로 찾아냅니다.
패턴이 없는 미공개 중요정보(MNPI)까지 찾아냅니다
계좌번호·카드번호는 형식이 있지만, 진행 중인 M&A나 고객 포지션, 공시 초안은 형식이 없습니다. Secuvy는 고객 데이터와 함께 이런 정보도 원위치에서 분류하고, 컴플라이언스 팀의 확인을 학습해 정확도를 높입니다.
Grant Thornton, 2026.4
설계도, 배합비, 공정 데이터 같은 영업비밀을 학습합니다
패턴 규칙은 신용카드 번호는 찾아도, 독자 공정 레시피와 평범한 엑셀 파일은 구분하지 못합니다. 무엇이 중요한지 정의하면 Secuvy가 설계·수식·코드를 IP로 찾아내고, 엔지니어의 확인으로 계속 정교해집니다.
Verizon DBIR 2026
자유 텍스트 속에 숨은 의료정보를 찾아냅니다
임상 AI는 진료 기록, 판독 소견, 연구 시스템, 스캔 문서에 의존합니다. 패턴 규칙이 놓치는 자유 서술형 문장 속 환자정보를 맥락으로 찾아내고, 대규모 규칙 세트나 라벨링 인력 없이 분류합니다.
HBR Analytic Services, 2025.10
보안 등급 표기가 아니라 실제 내용으로 분류합니다
문서는 복사·편집·병합되면서 표기된 등급과 실제 내용이 어긋납니다. Secuvy는 각 파일의 내용과 맥락으로 통제 대상 정보를 분류해, 표기가 빠지거나 낡은 경우에도 유출을 막습니다.
엔지니어가 쓰는 모든 형식의 민감 데이터를 분류합니다
단선도, 검층 기록, 터빈 센서 이력은 사무 문서 패턴과 맞지 않아 분류되지 않은 채 남습니다. Secuvy는 파일의 구조와 관계를 학습해 도면·모델·좌표 형태의 핵심 기반시설 정보와 IP까지 찾아냅니다.
규칙이 없는 페타바이트급 연구 데이터를 분류합니다
시뮬레이션 결과, 장비 데이터, 공동연구 기관의 파일은 반복되는 패턴이 거의 없습니다. Secuvy는 데이터가 바뀔수록 더 정확해지며, 연구 데이터 관리자는 확인만 하면 됩니다.
Cisco, 2025.9
국방 분야 고객이 2,500만 개 이상의 파일에 Secuvy를 적용해, 첫 분석만으로 40%를 조치 가능한 항목으로 식별했습니다.
NVIDIA 레퍼런스 설계 기반 AIDP에 통합되어, Hammerspace가 데이터를 옮기고 Secuvy가 무엇을 보낼지 결정합니다.
MCP, REST API, 커넥터, 웹훅으로 연동합니다. AIDP, Hammerspace, DLP, Microsoft Purview가 같은 태그를 기준으로 동작합니다.
Armada Bridge(국방·엣지), Carahsoft(미 공공), ePlus(글로벌 구축), 이프리키아(Efrikia Technology, 한국)
출처: secuvy.ai 솔루션·회사 소개 페이지 (2026.11 확인)
국내 규제 환경에서도
AI 데이터 거버넌스의 기반이 됩니다
개인정보와 중요정보가 어디에 있는지 아는 것이 모든 규제 대응의 출발점입니다. Secuvy는 분류 결과를 실행 가능한 정책으로 바꾸고 근거를 기록으로 남깁니다.
개인정보보호법
개인정보 처리 현황 파악과 안전한 활용
- 정형·비정형 데이터 전반의 개인정보·민감정보 자동 검출
- AI 학습 전 마스킹·가명·익명 처리 대상 식별
- 보존 기한이 지난 데이터 식별과 삭제 정책 적용
AI 기본법
AI 학습 데이터의 투명성과 관리 책임
- 파이프라인별 데이터 명세서(DBOM)로 학습 데이터 출처 기록
- 학습에 사용된 데이터와 제외된 데이터의 근거 보관
- RAG·LLM 입력 데이터에 대한 가드레일 적용
금융권 생성형 AI 활용
망분리 개선 흐름 속 내부 데이터의 안전한 AI 활용
- 고객정보·신용정보가 AI 서비스로 유출되지 않도록 사전 필터링
- 온프레미스·클라우드 어디서든 동일한 분류·통제 정책 적용
- 내부통제·감사 대응을 위한 처리 이력 제공
ISMS-P · 정보보호 관리체계
정보자산 식별과 중요도 분류
- 전사 데이터 자산 인벤토리와 중요도 등급 자동화
- DLP, IAM, SIEM, SOAR 등 기존 보안 솔루션과 분류 결과 연동
- 데이터 보안 상태 관리(DSPM)로 노출 위험 상시 점검
Secuvy 보유 인증 · SOC 2 Type II 인증, IAPP(국제 프라이버시 전문가 협회) 회원
해외 규제 프레임워크는 Secuvy 공식 대응 항목입니다. 국내 규제 항목은 대응을 돕는 기능을 정리한 것으로, 인증이나 법적 적합성을 보증하지 않습니다.
이런 조직에 필요합니다
- 업종금융, 의료·바이오, 국방·항공, 제조, 에너지 등 규제가 엄격하고 IP 비중이 높은 산업
- 규모임직원 2,000명 이상, 다수 사업장 또는 멀티클라우드 환경
- 데이터NAS·오브젝트·클라우드에 페타바이트급 비정형 데이터 보유
- 추진 과제RAG 구축, 사내 LLM 도입, 모델 학습 등 AI 사업 진행 중
- 담당 조직CISO, CDO, CIO, AI 추진 조직, 인프라·데이터 거버넌스 담당
이런 말씀을 하신다면
법무팀과 보안팀이 데이터 노출 위험을 지적해서 AI 도입이 멈췄습니다.
학습 데이터에 개인정보나 기밀이 섞여 있는지 증명할 방법이 없습니다.
정보보호 감사가 다가오는데, 이제 AI도 점검 대상이 됐습니다.
데이터를 활용하는 시간보다 찾고 정리하는 데 더 많은 시간을 씁니다.
소식
 2026.03
Secuvy와 Hammerspace, 모든 AI 파이프라인을 함께 지원
Secuvy가 NVIDIA 레퍼런스 설계 기반 Hammerspace AI 데이터 플랫폼에 통합되었습니다. Secuvy가 옮길 가치가 있는 데이터를 판단하면, Hammerspace가 이를 GPU까지 자동으로 이동합니다.
 2026.05
Armada Bridge 마켓플레이스 합류
엣지 환경의 AI를 위한 데이터 준비 플랫폼으로 Armada 마켓플레이스에 합류했습니다.
 FORRESTER · 2025 Q4
Forrester Landscape 보고서 등재
Forrester의 2025년 4분기 Landscape 보고서에 이름을 올렸습니다.
우리 회사 AI 데이터 준비도 자가진단
6개 질문에 답하면 현재 수준과 우선 과제를 바로 보여 드립니다. 응답은 이 화면에서만 계산되며 어디에도 저장되지 않습니다.
- Q1
사내 파일 서버·클라우드·SaaS에 어떤 개인정보와 기밀이 있는지 목록으로 파악하고 있다.
- Q2
AI 학습·RAG에 들어간 데이터의 출처와, 제외한 데이터의 근거를 제시할 수 있다.
- Q3
직원이 ChatGPT·Copilot 등 생성형 AI에 민감정보를 입력하는지 점검하고 있다.
- Q4
분류 규칙(정규식·키워드)을 사람이 계속 만들고 고치지 않아도 된다.
- Q5
설계도·소스코드·영업비밀처럼 정해진 패턴이 없는 IP를 자동으로 식별한다.
- Q6
온프레미스·클라우드 어디서든 같은 분류·통제 정책이 적용된다.
자주 묻는 질문
Secuvy는 무엇이고, 누구를 위한 제품인가요?
AI에 쓰일 기업 데이터를 자동으로 찾고 분류하고 통제하는 AI 데이터 인텔리전스 플랫폼입니다. DSPM, 데이터 연결 분석, AI 거버넌스를 하나로 제공하며 보안·컴플라이언스 조직과 AI·데이터 조직이 함께 사용합니다.
Secuvy가 데이터를 옮기거나 변경하나요?
아닙니다. 데이터는 원래 위치에 둔 채로 분류합니다. 마스킹이나 이동 같은 조치는 정책으로 정한 경우에만 실행되며, 데이터 이동은 Hammerspace와 연동해 자동화할 수 있습니다.
분류 규칙은 누가 관리하나요?
규칙을 일일이 만들 필요가 없습니다. 비지도 학습 기반 AI 엔진이 고객 데이터에 맞춰 스스로 적응하고, 담당자가 확인한 결과를 다시 학습해 정확도가 계속 높아집니다.
데이터 명세서(DBOM)란 무엇인가요?
Data Bill of Materials의 약자로, 각 AI 파이프라인에 어떤 데이터가 들어갔고 무엇이 제외되었는지, 현재 상태는 어떤지 정리한 기록입니다. 감사와 규제 대응의 근거 자료로 활용됩니다.
AI 데이터 준비(AI Data Prep)란 무엇인가요?
원시 데이터를 AI 학습·추론·RAG에 쓸 수 있도록 찾고, 분류하고, 정제하는 과정입니다. 데이터 엔지니어링 팀은 근무 시간의 60~80%를 이 작업에 쓰는데, Secuvy는 이 과정을 자동화합니다.
국내 도입과 기술지원은 어떻게 받나요?
이프리키아가 사전 컨설팅, PoC, 구축, 유지보수와 기술지원을 담당합니다. 아래 문의처로 연락 주시면 고객 환경에 맞는 도입 방안을 안내해 드립니다.
우리 데이터로 Secuvy를 직접 확인해 보세요
jh.kim@efrikia.com