

One Platform
하나의 플랫폼, 다섯 가지 활용
다른 솔루션은 새로운 사일로를 만듭니다. Hammerspace는 이미 보유한 스토리지를 하나로 묶습니다.
별도 전용 클라이언트도, 데이터 이관도 필요 없습니다.
AI
학습·추론·RAG 데이터를 GPU 가까이 자동 배치
하이브리드 클라우드
온프레미스와 AWS·Azure·GCP·OCI를 하나의 데이터 풀로
스토리지 통합
NAS·오브젝트·클라우드·테이프 등 이기종 스토리지 통합
협업
본사·지사·해외 거점이 같은 파일을 실시간 공유
성능
표준 Parallel NFS로 HPC급 처리 성능 제공
AI 데이터 준비, 가장 단순한 방법
엔터프라이즈 AI의 가장 큰 걸림돌은 GPU가 아니라 흩어진 데이터입니다. Hammerspace는 단절된 사일로를 하나의 AI 데이터 파이프라인으로 연결합니다.
Unify. 한곳에 모으지 말고, 하나로 묶으세요.
데이터를 중앙 스토리지로 복사하는 방식은 AI 프로젝트를 지연시킵니다. Hammerspace는 데이터를 원래 위치에 둔 채(Data-in-Place) 메타데이터만 흡수해, 모든 스토리지의 비정형 데이터를 즉시 목록화합니다.
Automate. 데이터 배치를 정책으로 자동화하세요.
데이터 엔지니어가 수작업으로 파일을 옮기던 일을 없앱니다. 목적 기반 정책(Objectives)에 따라 데이터가 필요한 연산 위치로 자동 이동하며, 사용자의 접근 경로와 애플리케이션 파일 경로는 바뀌지 않습니다.
Accelerate. AI 업무 속도를 높이세요.
GPU 클러스터, AI 애플리케이션, 에이전트가 필요로 하는 순간 데이터를 공급합니다. 별도 미들웨어 없이 리눅스 표준 기술만으로 동작합니다.
Hammerspace 핵심 기술
소프트웨어 기반(Software-Defined)으로 어떤 하드웨어, 어떤 벤더의 스토리지 위에서도 동작합니다.
글로벌 네임스페이스Global Namespace
여러 사이트와 클라우드에 흩어진 스토리지를 하나의 파일 시스템처럼 보여줍니다. 사용자는 데이터가 어디에 있는지 신경 쓰지 않아도 됩니다.
무이관 데이터 통합Data-in-Place Assimilation
기존 NAS의 데이터를 물리적으로 옮기지 않고 메타데이터만 흡수해 통합합니다. 대규모 이관 작업과 업무 중단이 없습니다.
데이터 자동 배치Data Orchestration
정책에 따라 데이터를 고성능·저비용 계층, 다른 사이트, 클라우드로 자동 이동합니다. 계층화, 백업, DR, 클라우드 버스팅을 하나로 해결합니다.
병렬 파일 시스템Parallel File System Architecture
리눅스 커널에 기본 탑재된 pNFS v4.2(Flex Files) 기반입니다. 메타데이터와 데이터 경로를 분리하고 RDMA를 지원해 수천 노드까지 선형 확장합니다.
Tier 0 스토리지Tier 0 Storage
GPU 서버에 내장된 NVMe를 공유 고성능 스토리지로 전환합니다. 외장 스토리지 추가 구매 없이 성능을 끌어올립니다.
데이터 저장 및 보호Data Storage and Protection
데이터 복제·계층화·보호 정책을 스토리지 종류와 관계없이 전사 공통으로 적용하고, 메타데이터 기반으로 거버넌스를 강화합니다.
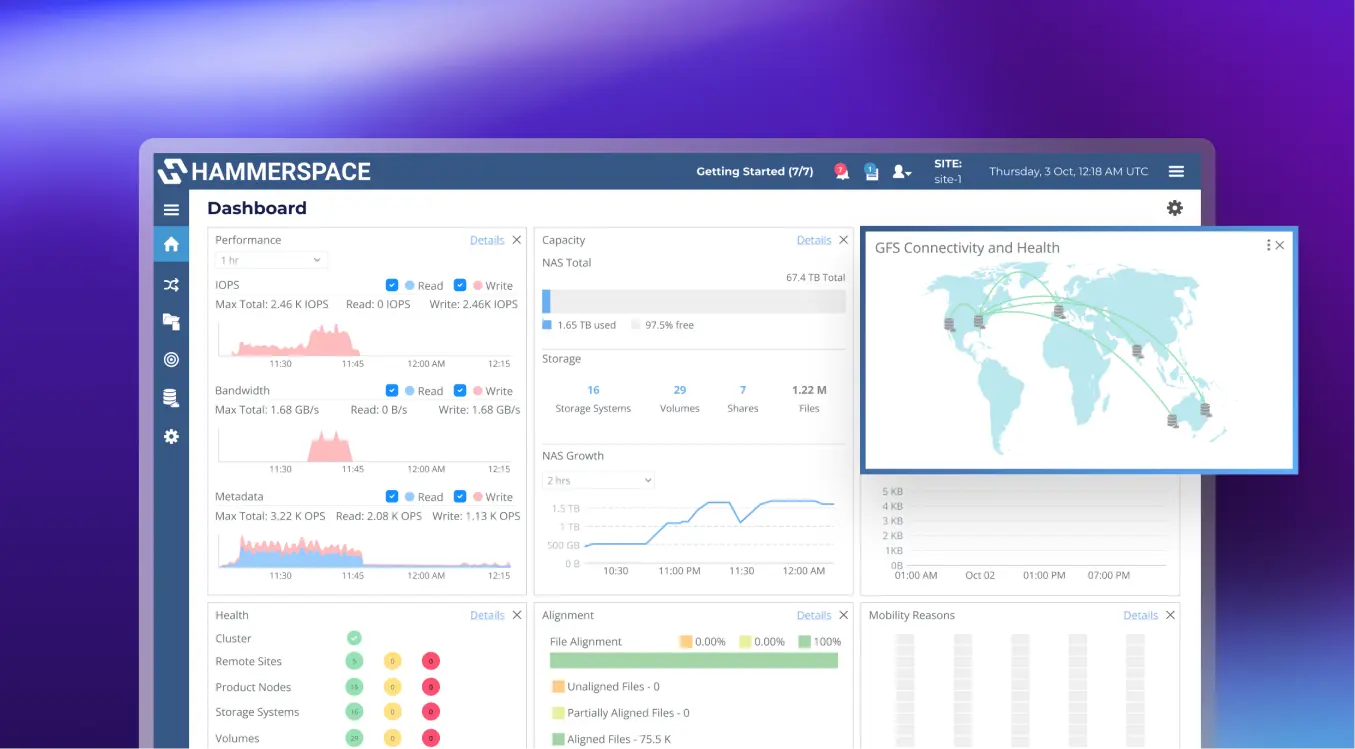
여러 사이트와 클라우드의 스토리지, 용량, 성능, 정책 적용 현황을 하나의 콘솔에서 확인합니다.
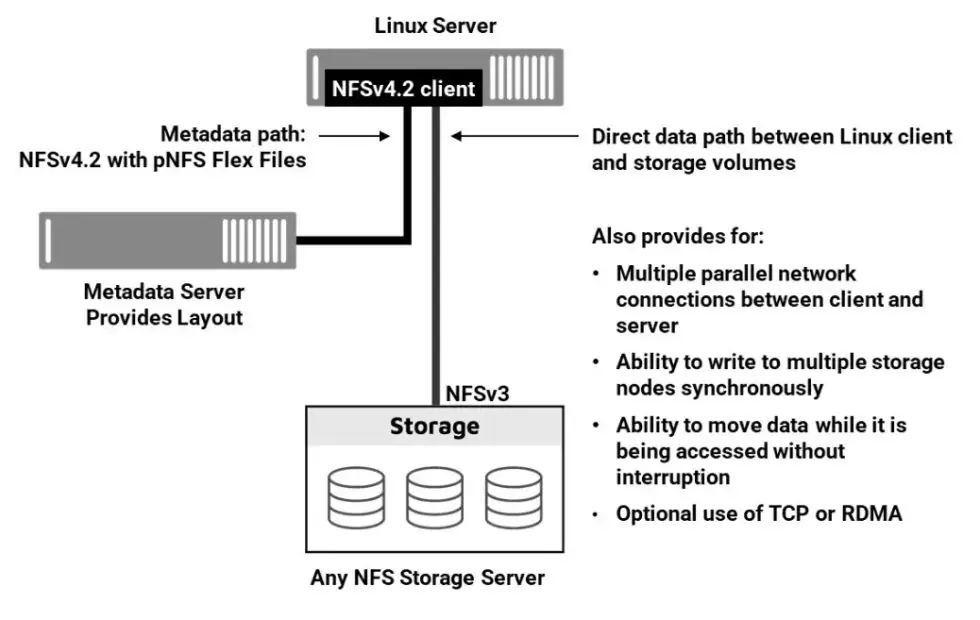
메타데이터 경로와 데이터 경로를 분리해, 리눅스 클라이언트가 스토리지 노드에 직접 병렬로 읽고 씁니다.
GPU 서버 내장 NVMe를
공유 고성능 스토리지로
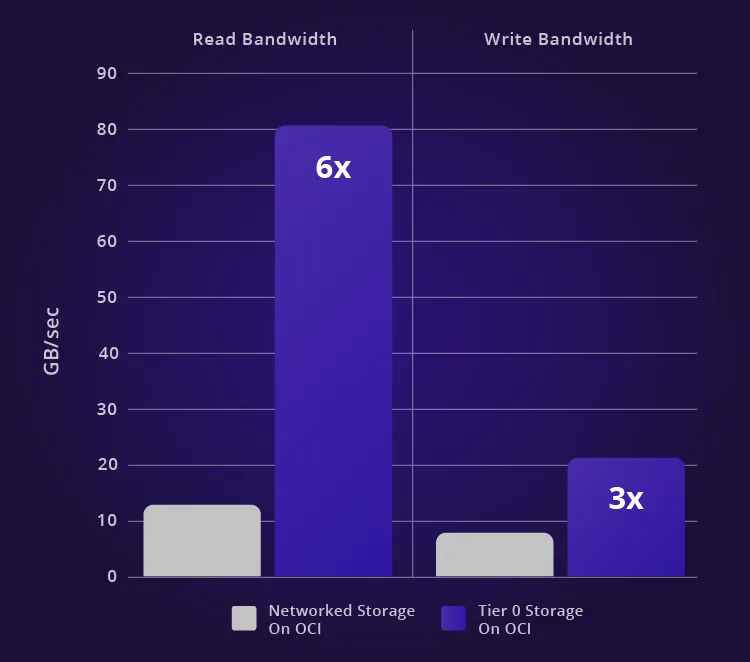
GPU 서버에는 이미 서버당 30~492TB의 NVMe가 장착되어 있지만, 대부분 캐시나 임시 저장소로만 쓰입니다. Tier 0는 이 용량을 클러스터 전체가 공유하는 보호된 스토리지 계층으로 바꿉니다.
- 클러스터 전체에서 서버 내장 NVMe를 공유 스토리지로 사용
- Tier 0와 대용량 계층 간 데이터 자동 이동
- GPU 서버에 별도 클라이언트·에이전트 설치 불필요
- 외장 스토리지 구매·전력·상면 비용 절감
로컬 NVMe 속도
오브젝트 · 클라우드
모든 계층이 하나의 글로벌 네임스페이스로 보입니다
Tier 0 데이터 흐름, 6단계로 보기
정책(Objective) 하나로 데이터가 GPU 옆으로 갔다가, 학습이 끝나면 다시 저비용 계층으로 돌아갑니다.
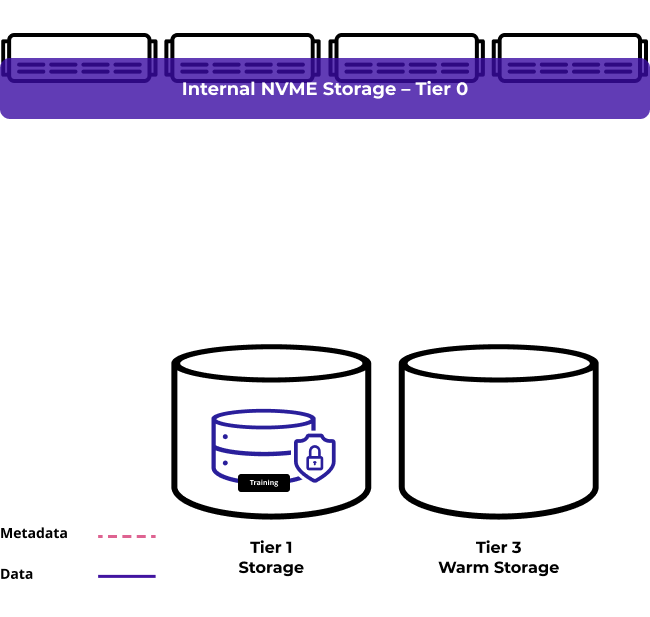
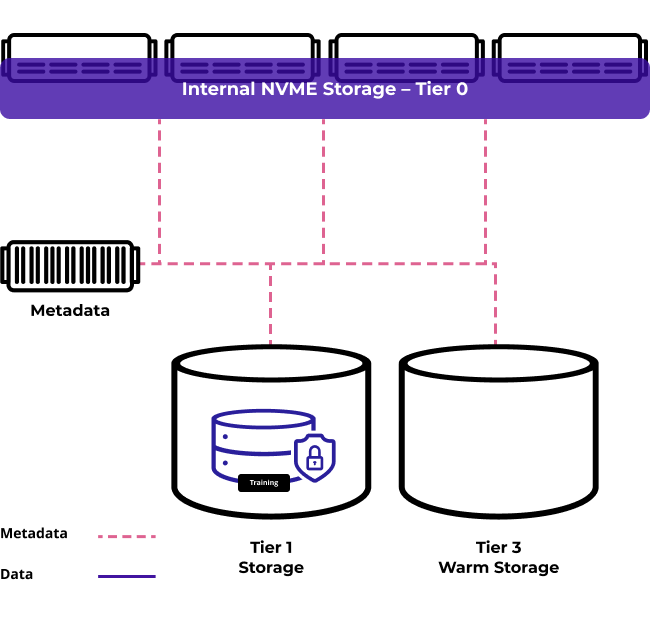
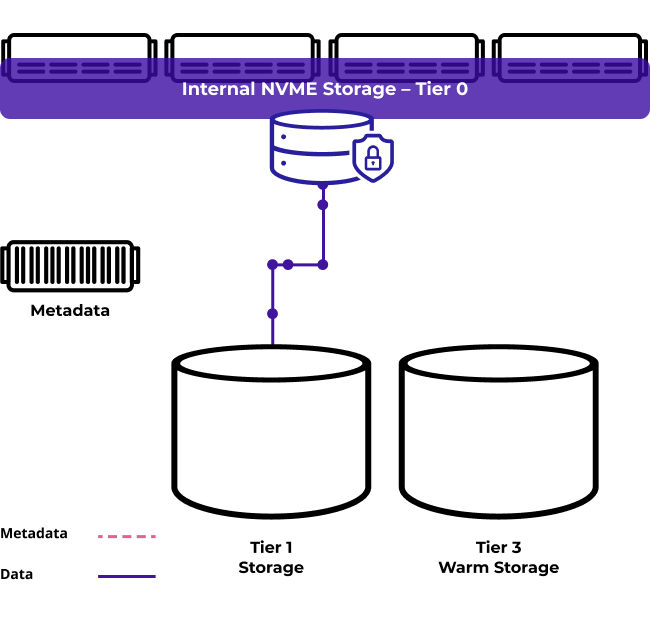
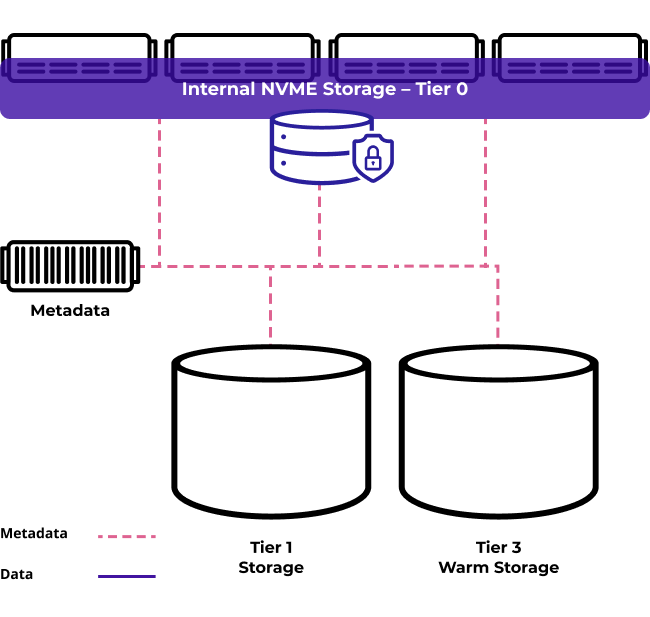
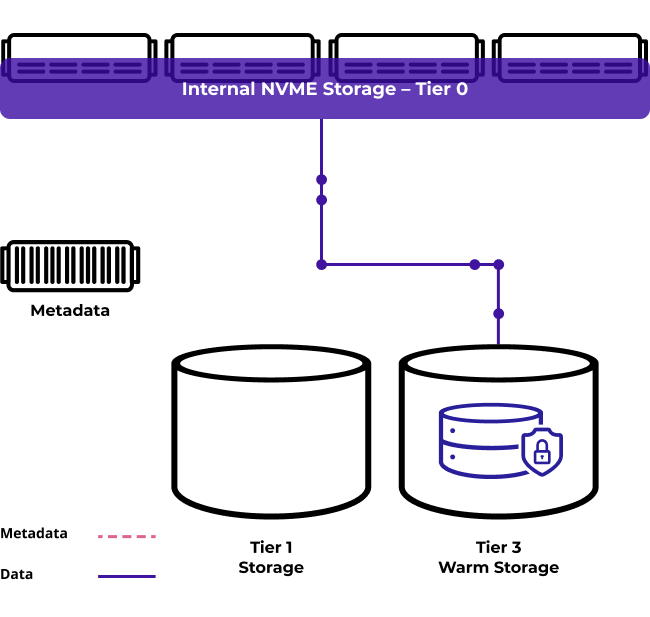
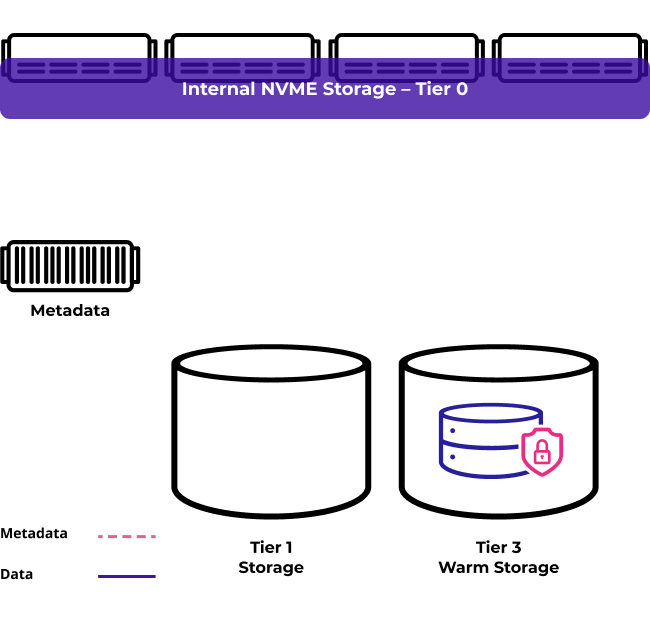
- 01데이터셋 위치 확인학습 데이터는 기존 Tier 1·웜 스토리지에 그대로 있습니다.
- 02정책(Objective) 지정"이 데이터셋을 GPU 서버 가까이" 같은 목표를 정책으로 설정합니다.
- 03Tier 0로 자동 이동파일 경로는 그대로 두고, 데이터만 GPU 서버 내장 NVMe로 옮깁니다.
- 04학습 수행·완료GPU는 로컬 NVMe 속도로 데이터를 읽고, 결과와 체크포인트를 기록합니다.
- 05저비용 계층으로 회수작업이 끝난 데이터는 정책에 따라 자동으로 저비용 스토리지로 이동합니다.
- 06전 과정 거버넌스모든 이동과 위치가 메타데이터로 기록되고 보호 정책이 유지됩니다.
Tier 0 효과 계산기
보유 중인(또는 도입 예정인) GPU 서버 기준으로 활용 가능한 Tier 0 용량과 절감 효과를 추정합니다.
20노드 GPU 클러스터·487TB 기준 Hammerspace 산정치($149.9K, 109,766kWh, 6U)를 용량에 비례해 단순 환산한 참고값입니다. 실제 효과는 BMT로 확인하세요.
AI 인프라 도입, 이런 고민이 있으신가요?
GPU 도입을 앞둔 국내 기업과 기관에서 가장 많이 듣는 고민입니다.
AI 업무 착수까지 걸리는 기간
| 구축 단계 | 기존 방식 (스토리지 신규 도입) | Hammerspace 도입 시 |
|---|---|---|
| 스토리지 확보 | 신규 장비 발주·납품 · 3~6개월 이상 | 기존 스토리지 그대로 활용 · 즉시 |
| 클라이언트 구성 | 전용 클라이언트 설치·검증 · 수주~수개월 | 리눅스 표준 내장 · 즉시 |
| 데이터 이관 | 기존 데이터 마이그레이션 · 2~4주 | 무이관 통합 · 즉시 |
| 운영 체계 | 업무 흐름 재구성 · 별도 기간 | 정책 기반 자동 배치 · 상시 |
| AI 업무 착수까지 | 약 14~30주 | 1일 이내 |
출처: Hammerspace KSC 2026 발표자료(2026.9, 서울). 실제 기간은 고객 환경에 따라 다를 수 있습니다.
공인 벤치마크로 검증된 성능
역대 가장 빠른 NFS 결과
삼성전자와 공동으로 달성. 경쟁 시스템 대비 적은 서버 수로 HPC급 성능을 기록했습니다.Storage v2.0 · Tier 0
노드당 85.6GB/s 처리량. 경쟁사 대비 노드당 16.5배 더 많은 GPU를 지원합니다.체크포인트 예상 시간
DGX B300 64대 기준, 일반 Tier 1 구성(2,246초) 대비 대폭 단축됩니다.IO500 10-Node Production · IOEasy 읽기 성능
같은 벤치마크, 다른 서버 규모. 보기 기준을 바꿔 보세요.
출처: io500.org 10-Node Production 목록 (Hammerspace Intro 2026.9 인용). 서버 노드당 성능 = IOEasy Read ÷ 스토리지 서버 노드 수.
업무별 활용 사례와
글로벌 구축 레퍼런스
금융, 공공, 연구, 미디어, 제조 분야의 고객이 Hammerspace를 어떻게 쓰고 있는지 활용 사례별로 정리했습니다.
GPU 클러스터에 데이터를 빠르게 공급하고, 온프레미스와 클라우드 GPU를 하나의 데이터로 함께 씁니다.
Pure Storage·NetApp 대체, 온프레미스와 GCP를 하나로
연구원·데이터 과학자 3,000명이 쓰는 AI 서비스 개발 환경. 기존 스토리지의 볼륨 5,000개를 흡수해 온프레미스와 GCP를 잇는 4PB 글로벌 파일 시스템을 구성하고, 수 PB 데이터를 최소 다운타임으로 이관했습니다.
Llama 2·3 학습, Llama 4 클라우드 확장
범용 스토리지 서버로 전체 12.5TB/s 성능을 구현했습니다. Llama 4에서는 OCI·AWS의 클라우드 GPU로 손쉽게 확장했습니다.
"What Hammerspace does is pure magic." — Paul Saab, Meta
AI 이상거래 탐지 파일럿
사기 탐지와 리스크 평가용 AI 파일럿 환경. 기존 NetApp 데이터를 흡수하고 Hitachi VSP One 스토리지 위에 100TB 클러스터를 구성해, 재설계 없이 확장할 수 있게 했습니다.
WEKA 대비 동등 이상 성능, 더 낮은 TCO
AI 모델 학습 클러스터의 4노드에 200TB Tier 0를 구성했습니다. CPU·메모리 사용이 적어 앞으로 더 저렴한 서버를 구매할 수 있게 되었습니다.
OCI 144노드 GPU에 Tier 0
온프레미스 NAS의 데이터를 OCI GPU에서 처리하기 위해 2PB 클러스터를 배포하고, 학습 결과는 오브젝트 스토리지로 자동 계층화했습니다.
공공기관 AI 인큐베이션 허브
H200 8장 GPU 클러스터와 NVIDIA AI Enterprise 기반으로 예측 분석, 증거 상관 분석을 위한 AI 기반을 구축했습니다.
전용 클라이언트 없이 HPC급 병렬 성능을 내고, 연구 조직마다 흩어진 파일 시스템을 하나로 합칩니다.
DGX SuperPOD 1,000노드를 위한 Lustre 대안
신규 AI 연산 클러스터에 pNFS v4.2로 데이터를 공급하고, 7개 파일 시스템을 하나로 통합했습니다. 2PB로 시작해 11PB로 확장 중입니다.
스토리지 교체 없이 비용 절감
750노드(GPU 80노드) 연구 클러스터의 서버 내장 스토리지를 Tier 0로 활용해 10PB 클러스터를 구성했습니다.
두 클러스터를 하나의 네임스페이스로
플래시 5.9PiB, HDD 13PiB 주 클러스터와 보조 클러스터를 통합해 AI/ML 도입을 가속했습니다.
Dell GPU 서버 4대로 502TB Tier 0
현미경 영상, 유전체 분석, LLM, CFD 등 다양한 연구 데이터를 처리합니다. 기존 NVMe 서버 371TB도 Tier 1로 재활용했습니다.
기존 NAS를 흡수하고 하위 계층으로 재활용
DGX B200 도입으로 처리량 요구가 두 배가 되자, PowerScale·TrueNAS 데이터를 흡수한 뒤 해당 장비를 Tier 2 용량으로 다시 썼습니다.
예산 제약 속 DGX H200 8대 활용
GPU 서버 내장 NVMe를 Tier 0로 구성해, 신규 연구 과제에 스토리지를 서비스 형태로 제공합니다.
본사·DR센터·해외 거점·클라우드를 하나의 파일 시스템으로 묶어 이중화, 장기 보관, 협업을 동시에 해결합니다.
콜센터 녹취 이중화와 7년 보관 규제 대응
고객 150만 명의 콜센터 녹취 파일을 캘리포니아·네바다 두 센터가 함께 쓰도록 구성하고, 오래된 파일은 GCP로 자동 이동해 7년간 보관합니다. BC/DR을 강화하고 규제 요건을 충족했습니다.
두 데이터센터 간 BC/DR
오스틴–라스베이거스 간 복제로 업무 연속성을 확보했습니다. NFS·SMB 동시 지원과 Active Directory 연동을 제공합니다.
미국·유럽 7개 사이트, 5PB 통합
사내 IT 인프라와 디지털 휴먼 프로젝트에 적용해, 3D 스캔 데이터를 LA·런던·세르비아가 함께 씁니다.
NetApp 교체, 3개 데이터센터 통합
NVMe 600TB와 오브젝트 9PB를 정책으로 운영합니다. 작은 파일은 NVMe에, 큰 파일은 디스크에 자동 배치합니다.
미국·유럽 클라우드 렌더링 파이프라인
AWS 리전 간 글로벌 파일 시스템으로 지연과 동기화 문제를 없애고, S3로 자동 아카이빙합니다.
시드니–밴쿠버 파일 공유
두 사이트의 Isilon을 하나의 네임스페이스로 묶어 수동 복사와 버전 충돌을 없앴습니다.
"I now define Hammerspace as the gold standard for global file systems."
노후 장비 교체(EOS) 시점에 기존 장비는 살리고, 데이터 이관 부담 없이 소프트웨어 기반 구조로 전환합니다.
노후 PowerScale을 교체하지 않고 계속 사용
예산 제약 속에서 Hammerspace를 PowerScale 앞단에 두고 메타데이터만 흡수했습니다. 데이터와 장비는 그대로 두고, 제3자 유지보수로 전환해 비용을 줄였습니다.
Isilon → Pure 이관, 최소 다운타임
댈러스·맨스필드 두 데이터센터를 하나로 묶어 BC/DR을 유지하면서 6억 개 파일을 이관했습니다.
EOL Isilon 대체
기존 PowerScale을 재사용하면서 범용 서버로 1.5PB 클러스터를 구성해 스토리지 비용을 낮췄습니다.
정부 대상 파일·오브젝트 서비스
NVMe Tier 1에서 NFS·SMB를 제공하고, 오래된 데이터는 기존 Cloudian으로 무중단 계층화합니다. 델리·푸네 2개 센터에 동일하게 구성했습니다.
NetApp은 유지한 채 Azure와 연동
흩어진 스토리지를 주 센터·DR 센터·Azure를 잇는 하나의 파일 시스템으로 통합해 설계 인력과 IT 팀의 생산성을 높였습니다.
3개 센터 공유 NAS 서비스
VMware 가상 환경과 범용 서버 위에서 동작하고, 오래된 데이터는 Cloudian으로 계층화합니다.
산업별 글로벌 레퍼런스
출처: Hammerspace Customer Success Stories (2026.5), Hammerspace Intro (2026.9)
고객 환경에 맞는 구축 방식
소프트웨어
베어메탈 또는 가상 서버에 설치하는 소프트웨어 방식. 기존 서버 자원을 활용합니다.
클라우드
AWS·Azure·GCP·OCI 마켓플레이스에서 바로 배포. 종량제와 프라이빗 오퍼를 지원합니다.
어플라이언스
검증된 하드웨어에 사전 통합된 형태. 올플래시·하이브리드 구성으로 빠르게 구축합니다.
현대 인프라의 설계자들이 만들었습니다
리눅스 NFS와 NVMe의 표준을 만든 엔지니어들이 Hammerspace를 개발합니다.
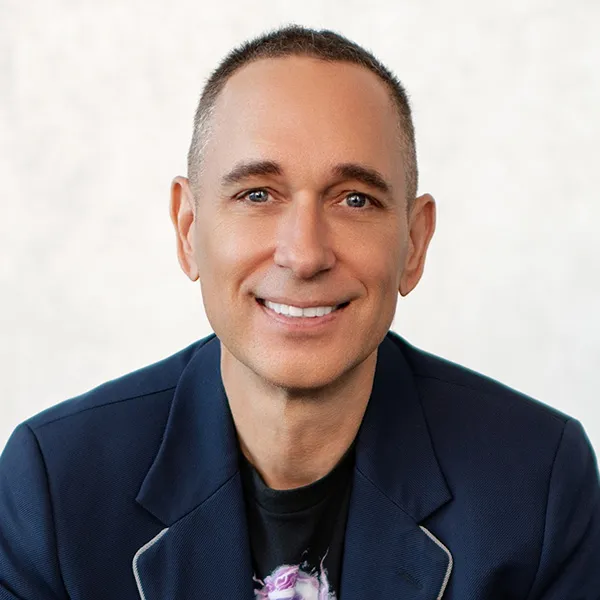
David Flynn
CEO · 공동 창업자. NVMe의 기반을 설계한 플래시 스토리지 혁신가, Fusion-io 공동 창업자
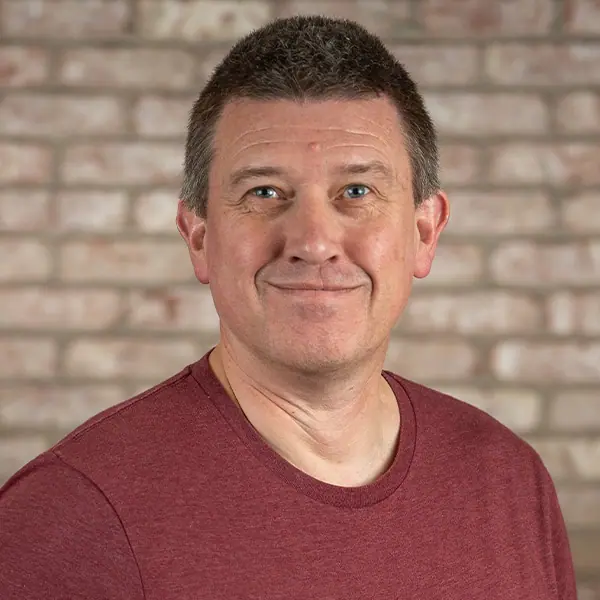
Trond Myklebust
CTO · 공동 창업자. 20년 넘게 리눅스 NFS를 이끌어 온 수석 메인테이너
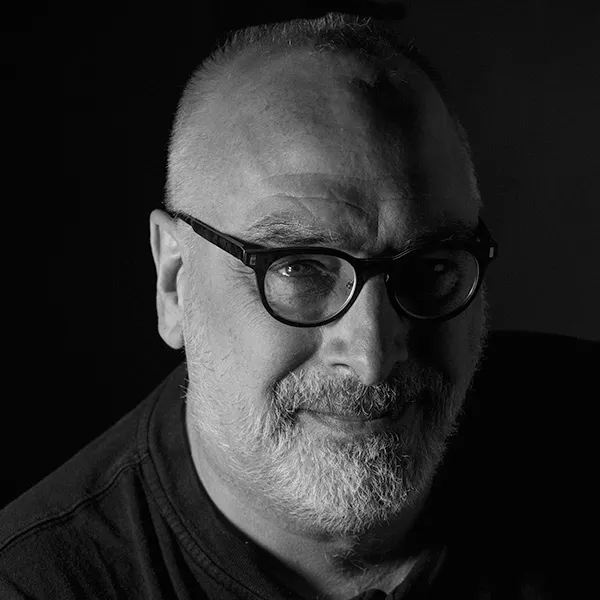
Brian Pawlowski
Sun에서 NFSv3를 공동 설계, NetApp CTO 역임
Tom Haynes
업계 표준인 NFSv4.2 프로토콜 공동 저자
Mike Snitzer
리눅스 스토리지 스택 핵심 기여자
- 2018회사 설립 · NFSv4.2 Flex Files 리눅스 표준 확정
- 2021Global Data Platform 출시
- 2023.07Series A $57M 투자 유치
- 2025.02한국 시장 진출
- 2025.04Series B $100M 투자 유치
- 2026.02SK그룹 투자
- 2026.04수주 전년 대비 14배 성장
- 2026.09KSC 2026 (서울) 발표
영상으로 보는 Hammerspace
썸네일을 누르면 페이지 안에서 바로 재생됩니다. (영어)
데이터 인프라 때문에
AI 프로젝트를 기다리지 마세요
현재 스토리지 구성과 GPU 도입 계획을 알려주시면, 이프리키아가 사전 컨설팅부터 BMT, 구축, 기술지원까지 함께합니다.
도입 문의하기 jh.kim@efrikia.com